카카오가 자체 인공지능(AI) 모델에 대한 안전성 검증 범위를 AI 에이전트까지 확대한다. 외부 전문기관과 모델의 위험요소를 점검하는 데서 나아가, 안전성을 지속적으로 검증할 수 있는 평가 체계와 도구를 함께 만드는 방식으로 협력을 넓힌다.
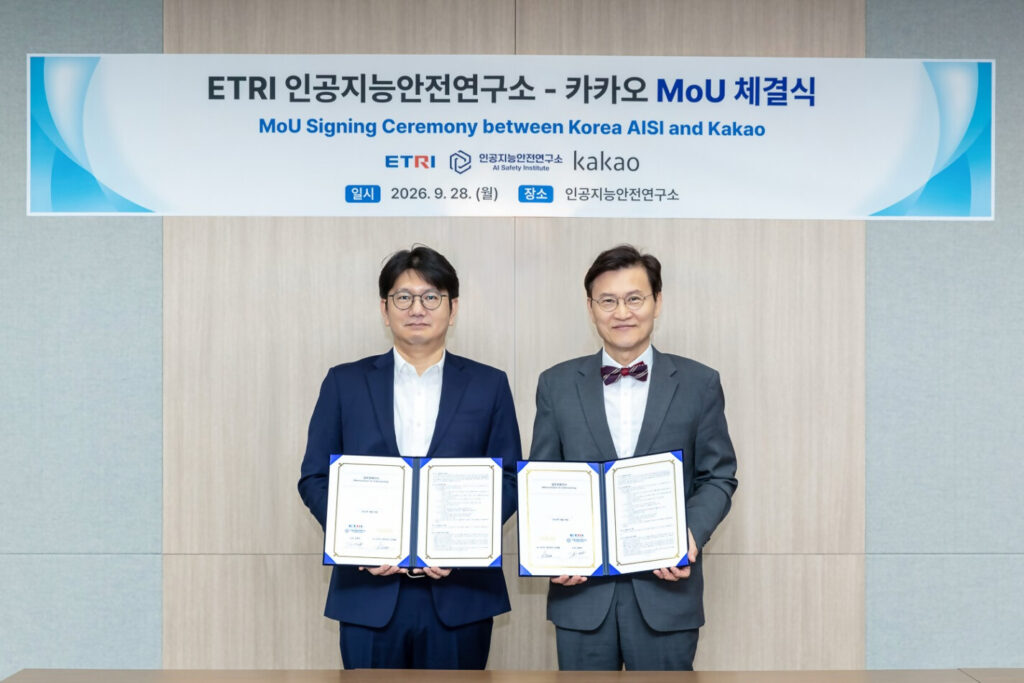
카카오는 인공지능안전연구소와 ‘AI 안전성 공동 평가 및 평가 체계 구축’을 위한 전략적 업무협약(MOU)을 체결했다고 29일 밝혔다.
지난 28일 체결된 업무협약 내용을 보면, 이번 협력은 AI 모델의 잠재적 위험을 사전에 식별하고 검증할 수 있는 평가 기반을 마련하는 데 초점을 맞췄다. 카카오는 평가 대상이 되는 자사 AI 모델과 AI 에이전트를 제공하고 평가 수행과 도구 개발에 필요한 인프라를 지원한다.
인공지능안전연구소는 실제 평가와 평가 방법론 고도화를 맡는다. 평가가 끝난 뒤에는 양측이 결과를 함께 검토하고 외부 공개 범위도 협의한다. 향후 AI 안전성 평가도구 개발 역시 공동으로 추진한다.
협력은 세 단계로 진행된다. 첫 단계에서는 언어모델을 대상으로 배포 전과 배포 이후의 안전성을 평가한다. 다음 단계에서 멀티모달 언어모델과 AI 에이전트로 평가 대상을 넓힌다. 마지막 단계에서는 AI 모델과 에이전트의 안전성을 보다 효율적으로 점검할 수 있는 평가도구를 공동 개발한다.
양측의 협력은 이번이 처음은 아니다. 지난해 카카오의 자체 언어모델 ‘Kanana-1.5-9.8B’를 대상으로 공동 안전성 평가를 진행했으며, 당시 유사한 규모의 해외 모델과 비교해 높은 수준의 안전성을 확인했다. 이번 MOU는 개별 모델 평가에 머물렀던 협력 범위를 지속적인 평가 체계 구축으로 확장한다는 데 의미가 있다.
김세웅 카카오 AI 시너지 성과리더는 “이번 협력을 통해 카카오 AI 모델이 더욱 객관적이고 엄격한 안전성 검증 체계를 갖추게 됐다”며 “앞으로도 기술 혁신과 함께 안전성과 신뢰를 최우선으로 하는 AI 모델과 서비스를 제공하기 위해 지속적으로 노력하겠다”고 말했다.
김명주 인공지능안전연구소 소장은 “AI 기술이 고도화될수록 잠재적 위험을 선제적으로 식별하고 평가하는 체계가 무엇보다 중요하다”며 “카카오와의 협력을 통해 글로벌 표준에 부합하는 AI 안전성 평가 체계를 구축하는 데 최선을 다하겠다”고 밝혔다.
카카오는 AI 안전성 관련 외부 협력과 내부 관리 체계도 운영하고 있다. kt cloud와 안전한 AI 생태계 구축을 위한 업무협약을 맺었으며, 외부 전문가가 참여하는 ‘AI&기술윤리소위원회’ 자문단을 운영하고 있다.