개인화 인공지능(AI) 에이전트가 이용자의 과거 정보에서 필요한 내용을 다시 찾아오는 작업에 활용할 수 있는 기술을 카카오가 외부에 공개했다. 질문과 문서의 단어가 일치하는지보다 의미가 얼마나 가까운지를 따져 정보를 선별하는 임베딩 모델이다.
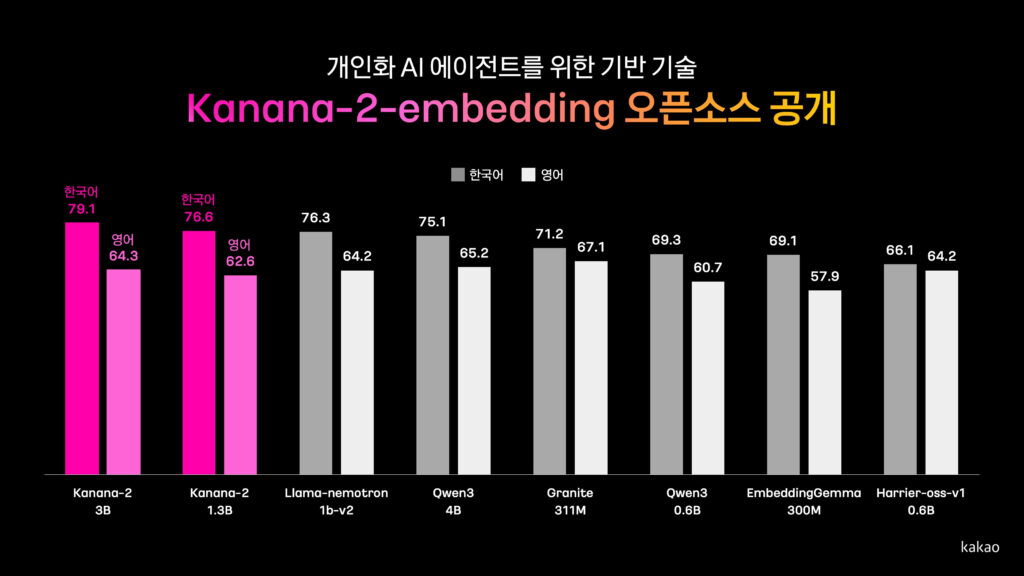
카카오는 29일 ‘Kanana-2-embedding’ 제품군 가운데 파라미터 30억 개의 ‘Kanana-2-3b-embedding’, 13억 개의 ‘Kanana-2-1.3b-embedding’을 허깅페이스에 올렸다고 밝혔다. 지난 7월 소형 언어모델 4종을 선보인 데 이은 자체 AI 모델 개방이다.
임베딩은 문장의 의미를 숫자 벡터로 바꿔 질문과 자료의 관련성을 판단한다. 예컨대 식당 이름을 말하지 않고 과거 대화에서 언급한 조용한 장소를 다시 물어도, 표현이 유사한 기록을 후보로 찾아낼 수 있다. 생성형 모델이 답변을 구성할 때 참고할 정보를 확보하는 데 쓰이는 방식이다.
운영 환경에 따라 데이터 표현의 크기를 달리할 수 있는 점도 이번 모델의 설계 요소다. 카카오는 MRL(Matryoshka Representation Learning)을 채택해 개발자가 임베딩 벡터 차원을 조정하도록 했다. 검색 성능에 필요한 수준과 저장 용량, 처리 속도 사이에서 서비스별 선택이 가능하다는 설명이다.
학습 과정에서는 카나나의 소형 언어모델 ‘Kanana-2-SLM’을 활용해 3B 모델을 먼저 만들었다. 이후 3B에서 학습한 내용을 작은 모델로 옮기는 지식 증류를 통해 1.3B 모델을 구축했다.
성능에 대해 카카오는 ‘llama-nemotron-embed-1b-v2’ 및 ‘Qwen3-Embedding-4B’와 대조한 평가에서 공개 모델들이 한국어 항목에서 가장 높은 성적을 거뒀다고 설명했다. 영어 항목에서는 비슷한 수준이었으며, 추론 효율은 Qwen3-Embedding보다 높게 나타났다고 덧붙였다.
종전 카나나 임베딩 시리즈와 비교하면 검색 성능이 개선됐고 메모리 사용과 추론 속도 측면에서 수십 배 이상의 효율 향상을 확인했다고 밝혔다.
카나나 오픈 라이선스를 적용한 만큼 연구 목적 이외에도 라이선스가 정한 범위에서 상업적으로 사용할 수 있다. 회사는 향후 더 큰 언어모델을 임베딩 학습에 적용하고 지식 증류 연구를 계속할 예정이다.
노병석 카카오 유니파이드 파운데이션 모델 성과리더는 이용자 맞춤형 AI 구현에 필요한 정보를 정확히 찾아주는 능력이 중요하다며, 관련 기술을 다양한 서비스에 활용할 수 있도록 지원하겠다는 뜻을 밝혔다.