[AI 요약] 딥러닝 프로젝트에서 기업들이 처리해야 하는 작업이 증가하고 있지만 모델이 점점 커지고 있다는 것이 문제이다. 그래서 모델 개발과 트레이닝 관련 성능부족, 간선 현상을 어떻게 해결할 지에 대한 답이 필요한데, 이를 위해 데이터 처리 최적화, 데이터를 가까이에 두고 성능을 해결하는 것이 기본 중의 기본이라는 것 외에도 네트워크 토폴로지 최적화는 어려운 과제라고 한다. 딥러닝 전문가가 될 필요는 없지만, 딥러닝 클러스터를 쓰는 곳이라면 이들 기술을 이해도 바탕이 되어야 한다.
딥러닝 프로젝트에서 컴퓨팅 성능에 대한 기업의 고민이 깊어지고 있습니다. 클러스터가 처리해야 하는 작업은 나날이 늘고있죠. 문제는 모델이 점점 커지는 데다 트레이닝을 위해 사용하는 데이터 양이 많아지고 있다는 것입니다.
그래서 모델 개발과 트레이닝 관련 성능부족, 그리고 병목 현상을 어떻게 해결할 지에 대한 답이 필요합니다.
이러한 성능문제에 대해 정답은 없습니다. 사례에 따라 병목을 일으키는 원인과 구간이 다를 수도 있죠. 물론 성능 문제 해결을 위한 기본은 먼저 데이터 처리 최적화 입니다. 데이터가 이동하는 경로를 최단으로 잡는 것이 중요합니다. 데이터를 가까이에 두고 성능을 해결하는 것이 기본 중의 기본이죠.
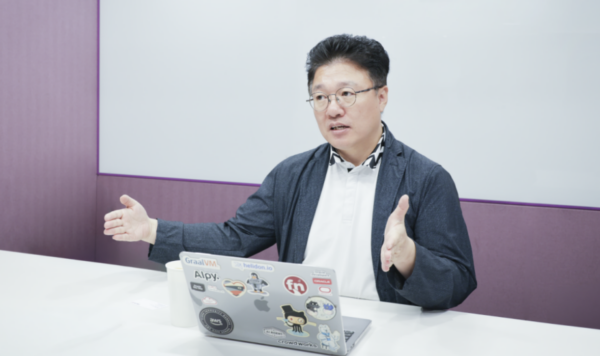
유클릭의 김광정 상무와 비대면 인터뷰를 통해, 대규모 분산 컴퓨팅 환경에서 딥러닝 프로젝트에 필요한 네트워크와 스토리지 성능 문제 해결 팁을 들어봤습니다.

콜드와 핫 데이터 구분이 중요

다른 분야와 마찬가지로 딥러닝 역시 티어링 개념을 적용해 가까이 둘 데이터와 거리를 조금 두어도 되는 데이터를 구분합니다.
자주 쓰지 않는 콜드 데이터 성격의 데이터 세트는 가성비가 좋은 오브젝트 스토리지에 저장합니다. 사용 빈도가 더 높은 웜 데이터는 올플래시 스토리지 같은 고성능 스토리지에 둡니다.
그리고 매우 빈번하게 사용하는 핫 데이터는 로컬 캐시나 메모리를 이용하는 것이 가장 좋습니다. 보통 GPU를 이용하는 환경에서는 GPU 메모리를 사용합니다.

딥러닝 트레이닝 관련 속도와 효율에 영향을 끼치는 네트워크 토폴로지 최적화는 어려운 과제입니다. 알아야 할 것이 너무 많죠. InfiniBand, RoCE, RDMA, SHARP(Scalable Hierachical Aggregation & Reduction Protocole), AR(Adaptive Routing) 등을 두루 알아야 하죠.
또한 GPU 클러스터를 쓰는 곳이라면 NVLink, GPUDirect 등의 기술 이해도 바탕이 되야 합니다.
이 모든 것에 통달하는 것은 사실 딥러닝 클러스터 사용자 관리자의 몫이 아닙니다. 본영의 업무가 아니죠. 그렇다면 어떻게 네트워크 토폴리지 최적화를 바탕으로 스토리지 병목 문제를 해결할 수 있을까요?
딥러닝 및 GPU 클러스터 관리자가 네트워크, 스토리지 전문가가 될 필요는 없다
몇가지 팁을 정리해 봅니다.
첫번째는 cnvrg.io나 slurm 같은 도구를 이용하는 것입니다. 트레이닝 잡과 사용자 관련 자원 오케스트레이션 자동화 도구를 이용하면 손쉽게 성능 문제를 해결할 수 있습니다. 데이터센터 인프라 모니터링 솔루션으로 GPU 활용률, 텐서코어 활용률, CPU 활용율, IO 평균값 등을 체크하면서 선제적으로 성능 문제가 생기기 전에 아이들 잡 같은 것을 정리하는 것도 방법일 수 있죠.

NVIDIA A100 GPU를 장착한 최신 시스템을 사용 중이라면 NVIDIA Magnum IO의 혜택을 누릴 수 있습니다. 이 기능은 NCCL, NVLink, NVSwitch, GPUDirect P2P, GPUDirect RDMA, GPUDirect Storage, UCX, MPI 같은 기술을 활용해 IO를 가속합니다. 물론 사용자는 이들 기술을 몰라도 됩니다. 그저 이 기술이 제공하는 가속의 혜택을 Magnum IO로 간편이 누리면 됩니다.

이 밖에도 코드 수준에서 가속하는 방법도 있습니다. NGC가 제공하는 최신 소프트웨어, 컨테이너 이미지 등을 이용하면 CUDA-X 환경에서 딥러닝 프레임워크를 손쉽게 가속할 수 있습니다.

이상으로 딥러닝 클러스터 성능 이슈를 네트워크와 스토리지 측면에서 어떻게 해결할 수 있는지 간단히 알아 봤습니다.