카카오브레인이 지난해 12월에 공개한 초거대 멀티모달(multimodal) AI ‘minDALL-E(민달리)의 업그레이드 버전인 이미지 생성 모델 ‘RQ-Transformer’를 최대 오픈소스 커뮤니티 깃허브(GitHub) 에 공개했다고 19일 밝혔다.
39억 개의 매개변수(파라미터)로 구성된 ‘RQ-Transformer’는 3000만 쌍의 텍스트-이미지를 학습한 text-to-image AI 모델로, 계산 비용을 줄이고 이미지 생성 속도를 높인 동시에 이미지의 품질을 크게 향상시킨 것이 특징이다. 카카오브레인이 공개한 RQ-Transformer는 공개된 이미지 생성 모델 중 국내 최대 크기의 이미지 생성 모델이며, 이를 공공 목적을 위해 공개했다는 점에서 AI 커뮤니티에 기여가 클 것으로 기대를 모으고 있다.
‘RQ-Transformer’는 카카오브레인의 초거대 멀티모달(multimodal) AI ‘minDALL-E(민달리)’의 업그레이드 버전으로, ‘minDALL-E’ 대비 모델 크기는 3배, 이미지 생성 속도와 학습 데이터셋 크기는 2배 늘렸다. 특히 ‘minDALL-E’의 경우 미국의 인공지능 개발 기업 ‘오픈AI(OpenAI)’가 공개한 ‘DALL-E’를 재현하는 것에 가까웠던 것에 반해, ‘RQ-Transformer’의 경우는 카카오브레인 만의 독자적인 기술로 개발됐다.
또 고해상도의 이미지를 2차원의 코드맵으로 표현하는 기존 기술과 달리 ‘RQ-Transformer’는 3차원의 코드맵으로 표현된 이미지를 순차적으로 예측해 생성하도록 학습된 이미지 생성 모델이다. 기존 기술과 비교했을 때 이미지 압축으로 인한 손실이 적어, 높은 품질의 이미지를 저해상도의 코드맵으로 표현하는 것 또한 특징 중 하나다. 이를 통해 ‘RQ-Transformer’는 기존 이미지 생성 모델보다 적은 계산 비용과 높은 이미지 생성 속도를 달성할 수 있다.
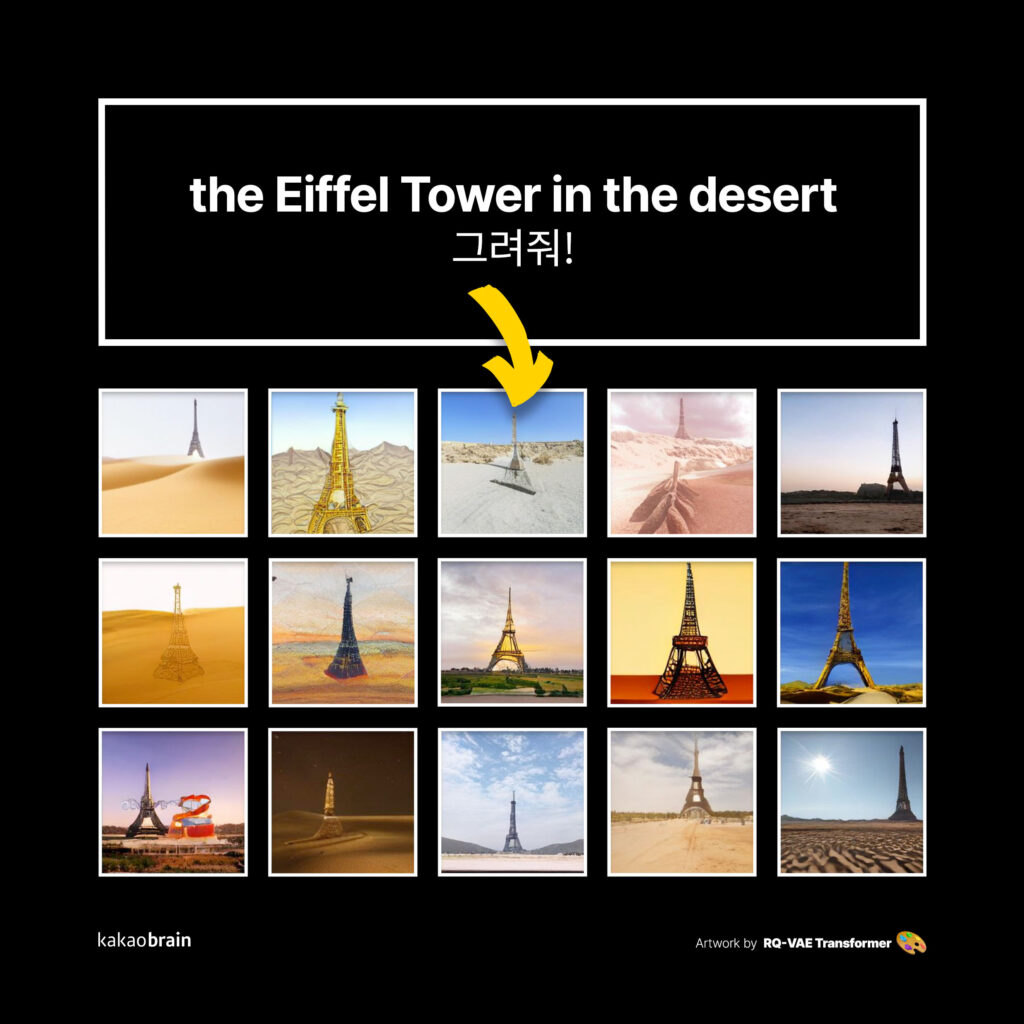
대규모 데이터셋을 바탕으로 학습된 ‘RQ-Transformer’는 처음보는 텍스트의 조합을 이해하고, 이에 대응되는 이미지를 생성할 수 있다.


소셜댓글